Реальная точность распознавания русской речи на телефонном звонке — 78–86 % по словам, то есть 14–22 % слов движок слышит неправильно. Паспортные 95 % и выше, которые показывает вендор, тоже честные: их измеряют на чистой записи одного человека, читающего подготовленный текст в тихой комнате на нормальный микрофон. Между этой записью и вашим звонком из цеха на мобильный лежат шесть факторов, каждый из которых отнимает свои проценты.
Хорошая новость в том, что все шесть факторов измеримы и чинятся по отдельности, причём два самых дорогих по эффекту чинятся вообще без денег — настройками записи в вашей же телефонии. Плохая — в том, что ошибки распределены не равномерно: они садятся ровно на те слова, ради которых расшифровку и заказывали, — на фамилии, суммы, даты и артикулы.
Ниже — разбор точности как инженерной величины: что означает цифра в коммерческом предложении, как посчитать свою за три дня и пятнадцать тысяч рублей, что делать с остатком ошибок и в каком случае мерить вообще не нужно. Все расчёты идут на одной модельной компании: 6 000 звонков в месяц, средняя длительность 3 минуты, то есть 18 000 минут аудио, ставка сотрудника, который разбирает результат, — 1 200 ₽/час с учётом взносов.
«Точность 95 %»: что именно измерили и на чём
Точность распознавания речи меряют метрикой WER — доля ошибок по словам. Считается она просто: берётся эталонная расшифровка, сделанная человеком, и машинная, а дальше подсчитывается, сколько слов пришлось бы вставить, удалить и заменить, чтобы превратить одну в другую. Сумма делится на число слов в эталоне. WER 18 % означает, что на каждые сто слов эталона приходится восемнадцать правок.
Доля ошибок по словам: сумма вставок, удалений и замен, делённая на число слов в эталонной расшифровке. Точность — это 100 % минус WER. Метрика не различает, ошиблись вы в союзе «и» или в фамилии клиента, поэтому одна она никогда не описывает пригодность расшифровки для дела.
Отсюда первый практический вывод: цифра из презентации бессмысленна без описания записи, на которой её получили. Прежде чем сравнивать двух подрядчиков по числу в коммерческом предложении, спросите у обоих три вещи — на каком корпусе меряли, какая там частота дискретизации и сколько говорящих на дорожке. Если ответ звучит как «на открытых данных», значит, речь идёт о чтении вслух в студийных условиях, и к вашим звонкам это отношения не имеет.
Второй вывод — про базу отсчёта. Для русского языка современные движки на чистой записи одного диктора дают 4–7 % WER, и это потолок, от которого дальше идёт вычитание. Никакой вендор не уводит эту цифру к нулю, и обещание «99 % на ваших звонках» — маркер того, что разговаривать дальше не о чем.
Третий вывод — про подмену метрики. В коммерческих предложениях встречаются ещё две цифры, и обе выше WER, поэтому их любят показывать вместо него. Первая — точность по символам: она считает буквы, а не слова, и одна неверная буква в середине слова портит её на доли процента, тогда как слово при этом становится другим. Вторая — точность по ключевым словам: движок проверяют на том, нашёл ли он десяток заранее выбранных фраз, и в этой постановке 95 % — обычный результат даже на плохой записи. Ни одна из двух не описывает пригодность расшифровки для заполнения карточки. Если в предложении стоит процент без указания метрики, это первый вопрос на встрече.
Почему 18 % ошибок по словам — это не 18 % испорченных звонков
Разрыв между метрикой и пользой работает в обе стороны, и это главное, что стоит понять до подписания договора. В одних задачах 18 % ошибок почти не мешают, в других делают расшифровку непригодной к автоматической обработке.
Возьмём трёхминутный звонок. При темпе 110–140 слов в минуту и доле молчания 8–15 % в нём звучит около 350 слов. WER 18 % — это 63 испорченных слова. Но если задача — определить тему обращения и повесить теги, то тема в разговоре избыточна: она повторяется десятком разных слов, и потеря шестидесяти из трёхсот пятидесяти её не скрывает. Точность классификации темы при таком WER держится на уровне 88–93 %. Это тот случай, когда расшифровка среднего качества полностью решает задачу — и именно на нём строится речевая аналитика, где важна не буква, а факт события в разговоре.
Теперь та же расшифровка для автозаполнения карточки в CRM. Значимых полей в обычном коммерческом звонке около двенадцати: имя, компания, телефон, адрес, товар или услуга, количество, цена, сумма, дата отгрузки или визита, номер заказа, номер договора, имя ответственного. Если бы ошибки ложились по словам равномерно, на эти двенадцать пришлось бы 12 × 18 % = 2,2 повреждённых поля. На практике ошибки садятся на имена собственные, числа и номенклатуру примерно в полтора раза чаще, чем на речь в среднем: 25 % вместо 18 %. Двенадцать полей × 25 % = 3 повреждённых поля на каждый звонок.
Если считать ошибки независимыми, полностью чистой была бы одна карточка из тридцати: 0,75 в двенадцатой степени — это 3,2 %. На практике ошибки собираются в кучу (плохая запись портит сразу всё), поэтому чистых карточек больше — порядка 25–35 %. Но и это означает: две трети автоматически заполненных карточек содержат хотя бы одно неверное поле. Отсюда правило, к которому всё сводится: расшифровка идёт в подсказку человеку, а не прямо в базу.
Шесть факторов, которые роняют точность
Ниже — порядок влияния каждого фактора: насколько он двигает WER относительно чистой записи одного человека в тихой комнате. Это ориентиры для планирования, а не паспортные данные конкретного движка; свои числа вы получите замером по процедуре из раздела ниже. Ценность таблицы в другом: она показывает, что три фактора из шести чинятся настройками и организацией, а не выбором вендора.
| Фактор | Сколько добавляет к WER | Чем чинится | Во что обходится |
|---|---|---|---|
| Телефонная полоса 300–3400 Гц | +4–8 п.п. | Модель, обученная на телефонии; там, где разговор идёт через гарнитуру, — запись до сужения полосы | 0 ₽, выбор модели и точки записи |
| Фоновый шум: цех, улица, открытый офис | +3–15 п.п. | Гарнитура с направленным микрофоном, отдельная комната для телефонной группы, шумоподавление на стороне АТС | 3 000–8 000 ₽ за гарнитуру на человека |
| Перебивания и наложение речи | +до 10 п.п. на участках наложения, а это 5–12 % времени | Двухканальная запись: оператор и клиент на разных дорожках | 0 ₽, настройка в АТС |
| Акцент, диалект, дефекты речи | +2–8 п.п. | Ничем быстро не чинится; закладывается в ожидания и в выборочную проверку | Расход на проверку, а не на технику |
| Отраслевые термины и номенклатура | На самих терминах ошибка 25–40 % | Словарь из 300–500 своих слов, подсказка движку и постобработка текста | Около 22 000 ₽ разово |
| Имена, фамилии, названия компаний | На именах ошибка 30–50 % | Подстановка из базы контактов по номеру телефона вместо распознавания | Входит в интеграцию с CRM |
Сложение факторов даёт типичную картину живой компании: 6 % на чистой записи, плюс 6 пунктов за телефонный канал, плюс 3 за шум в помещении, плюс 2 за перебивания, плюс 1 за неоднородную речь — итого 18 %. Именно эта цифра и лежит в основе всех расчётов дальше. Если ваш процесс — приём заявок из тихого офиса в гарнитуру, вы окажетесь ближе к 12 %; если это диспетчерская стройки с мобильных, будет 22 % и хуже.
Микрофон оператора против записи с линии
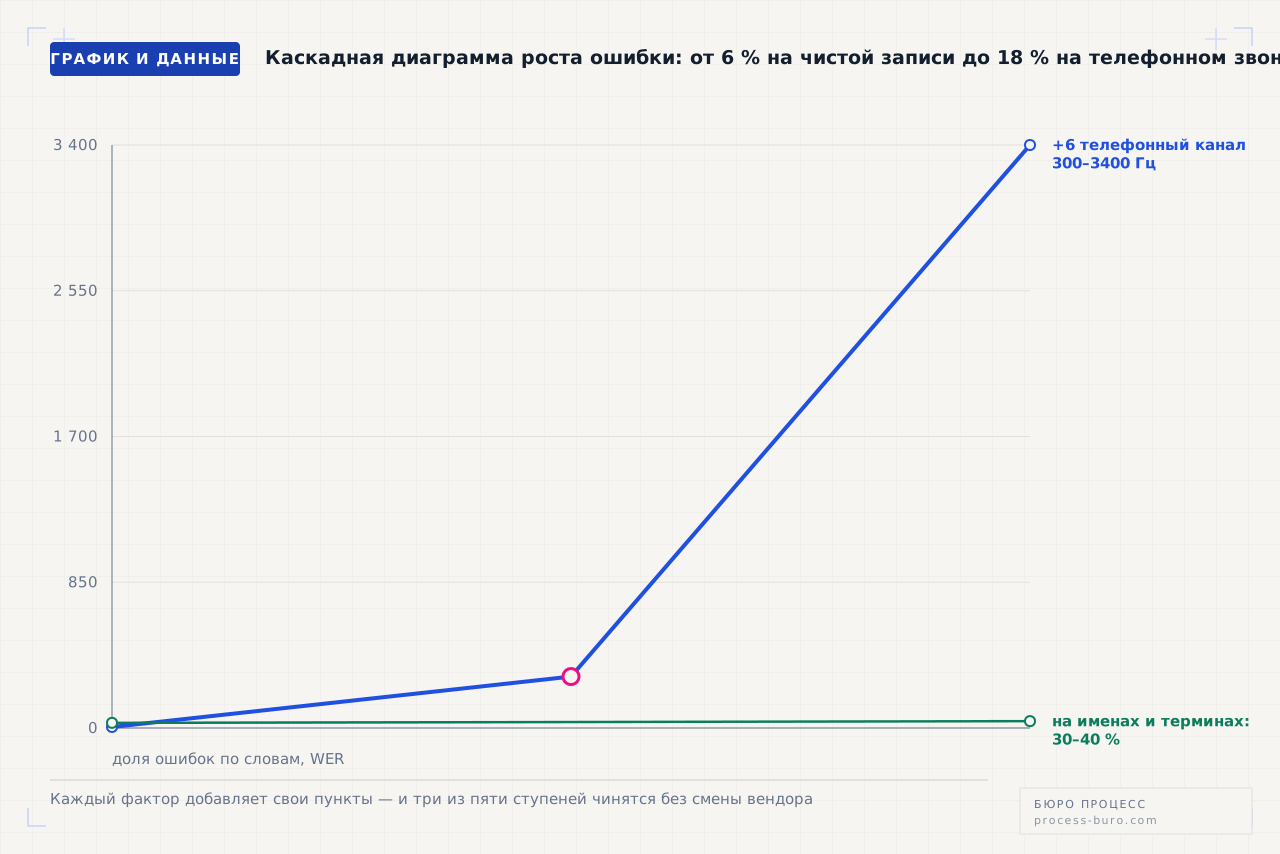
Это первое, что надо проверить в своей системе, и почти никто этого не делает, потому что вопрос выглядит техническим. Между тем разница в качестве между двумя точками записи одного и того же разговора доходит до пяти-семи пунктов WER — больше, чем разница между приличными движками.
Запись с линии — это то, что прошло через кодек. Полоса 300–3400 Гц, дискретизация 8 кГц, у мобильного плеча ещё и сжатие GSM. Из сигнала физически удалены частоты, по которым различаются шипящие и глухие согласные, — отсюда классические ошибки в фамилиях и в числительных, где «шестнадцать» и «шестьдесят» отличаются хвостом слова. Запись с гарнитуры оператора берёт голос до сужения полосы: 16 кГц и выше, один говорящий, без наложения.
Второй параметр важнее первого — в один файл смикшированы оба голоса или записаны две отдельные дорожки. При моно-миксе на участках, где клиент и оператор говорят одновременно, движок получает физически неразделимую смесь и выдаёт мусор; кроме того, ему приходится угадывать, кто говорит, а ошибка в разделении говорящих ломает любое правило вида «реплика клиента». Двухканальная запись снимает обе проблемы разом и в большинстве облачных АТС включается настройкой.
У российских операторов — Mango Office, Sipuni, UIS, Novofon (ранее Zadarma), МТС Exolve — запись разговоров есть везде, а вот в каком виде она отдаётся наружу, надо смотреть в конкретном тарифе и в документации на выгрузку: моно или два канала, какой кодек, какая частота, отдаётся ли исходник или перекодированный mp3. Это первый вопрос интегратору, а не пятый. Если запись отдаётся моно в mp3 на 32 кбит/с, дальше можно не обсуждать ни движки, ни словари.
Двенадцать полей, которые важнее общей точности
Общий WER — плохая приёмочная метрика, потому что он одинаково взвешивает союз и номер договора. Требование в договоре надо писать не по нему, а по критичным сущностям: их немного, они перечислимы, и по каждой понятно, что происходит при ошибке. Разбор ровно такой же логики для бумажных документов мы делали в материале о реальной точности распознавания документов — там метрика по полям расходится с метрикой по символам в разы, и здесь механика та же.
| Что извлекаем | Почему ломается | Чем чинится | Кто отвечает за ошибку |
|---|---|---|---|
| Имя и фамилия клиента | Имён собственных нет в языковой модели, телефонная полоса срезает окончания | Подстановка из базы контактов по номеру звонящего, распознавание — только для новых | Интеграция с CRM, не движок |
| Номер телефона | Цифры произносятся парами и группами, «двадцать два» слышится как «два два» | Нормализация числительных плюс проверка формата и контрольная длина | Постобработка |
| Сумма и цена | Совпадающие хвосты числительных, произношение «пятьсот» и «пять сот» | Правило разбора чисел плюс сверка с прайсом: сумма вне диапазона помечается | Постобработка и сверка с учётной системой |
| Дата отгрузки или визита | Разговорные формы: «в следующий вторник», «после праздников», «числа двадцатого» | Разбор относительных дат от даты звонка, подтверждение датой в ответной реплике | Постобработка |
| Товар, услуга, артикул | Номенклатуры нет в общем словаре языка, сокращения у каждого свои | Свой словарь на 300–500 позиций и подсказка движку | Словарь компании |
| Номер заказа и договора | Смесь букв и цифр, буквы называют по-разному: «эс», «эска», «си» | Маска формата и сверка с существующими номерами в базе | Постобработка и сверка |
Обратите внимание, где стоит ответственность: в четырёх строках из шести ошибку чинит не распознавание, а то, что происходит с текстом после него. Это меняет всю логику выбора подрядчика. Движок — покупной компонент с известной характеристикой, а разница между «расшифровка есть» и «карточка заполняется правильно» лежит в постобработке, сверке с учётной системой и словаре компании. За это и надо торговаться в смете, а не за лишний процент паспортной точности.
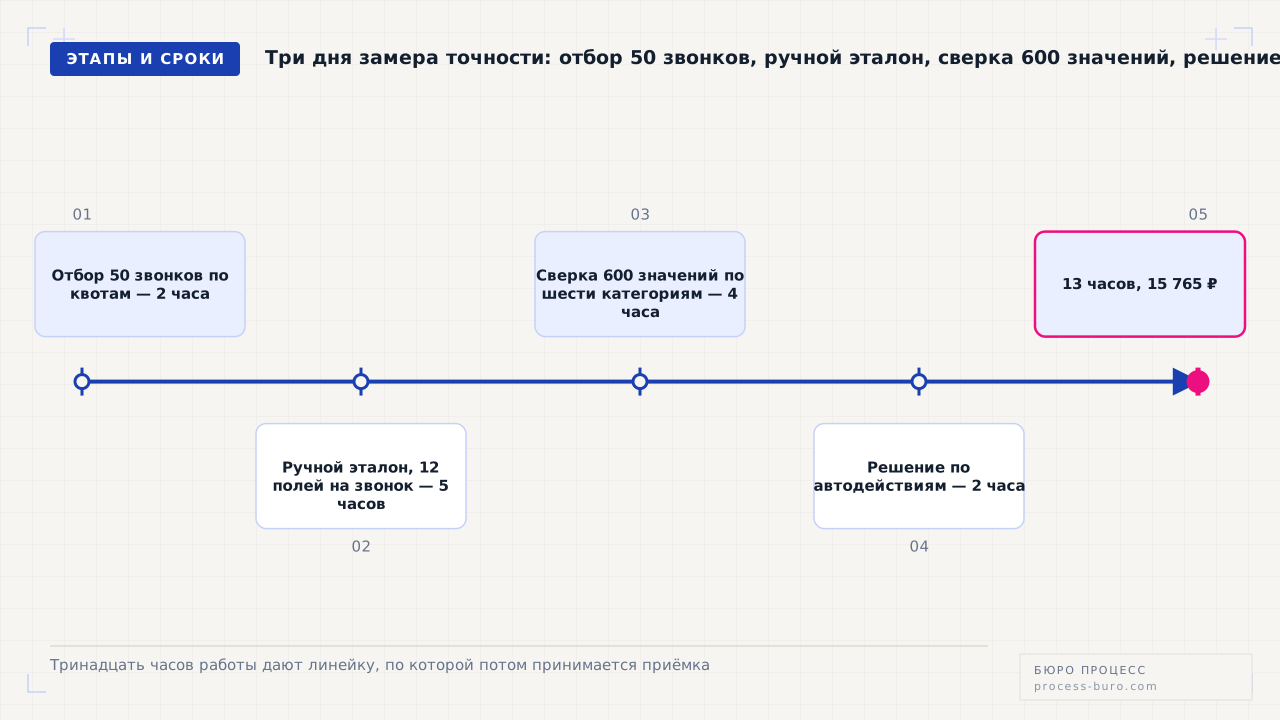
Как замерить свой уровень на 50 звонках за три дня
Замер нужен до подписания договора и до выбора движка. Пятьдесят звонков — минимальная выборка, на которой видны системные проблемы: при меньшем объёме один шумный цех или один оператор с быстрой речью перекосят всю картину. Считать надо не общий WER, а точность по тем самым критичным полям.
- 1День 1, два часа. Отбор выборки
Берём 50 звонков не подряд, а по квотам, чтобы выборка повторяла ваш реальный поток: по десять на каждый крупный источник (городской, мобильный, гарнитура, шумное место, разговор с перебиваниями). Из каждой группы звонки выбираются случайно, а не «покажите самый показательный» — иначе вы измеряете не систему, а чутьё того, кто выбирал.
- 2День 1–2, пять часов. Ручной эталон
Дословную расшифровку всех пятидесяти звонков делать не нужно — это вдесятеро дороже и не нужно для решения. Вместо неё сотрудник слушает звонок и заполняет бланк из двенадцати полей: имя, компания, телефон, товар, количество, сумма, дата, номер заказа и так далее. Шесть минут на звонок, 600 эталонных значений на выходе.
- 3День 2, полчаса. Прогон через распознавание
Те же 50 записей уходят в движок в том же виде, в каком к нему будут попадать в бою: тот же кодек, та же частота, тот же моно или стерео. 150 минут аудио по 1,10 ₽ за минуту — 165 ₽. Если сравниваете двух вендоров, прогон делается дважды на одном и том же файле-исходнике.
- 4День 3, четыре часа. Сверка по шести категориям
Каждое из 600 значений помечается как верное, повреждённое или пропущенное. Результат сводится не в одну цифру, а в шесть: имена, числа и суммы, даты, номенклатура, номера документов, прочий текст. Именно эта таблица показывает, что чинить первым — почти всегда это две категории из шести.
- 5День 3, два часа. Решение
На выходе — три числа: доля полей, пригодных без проверки; доля полей, которые надо проверять; список категорий-виновников. Дальше решение принимается арифметикой, а не впечатлением: если больше 30 % критичных полей повреждено, автозаполнение отключается и расшифровка остаётся подсказкой человеку.
Одна оговорка про исполнителя. Эталон не должен делать человек, чью работу потом будут оценивать по этим же расшифровкам, и не должен делать подрядчик, который продаёт вам систему. В первом случае бланк заполняется в свою пользу, во втором — в пользу движка, и в обоих замер теряет смысл ровно тогда, когда он нужнее всего. Подходит любой внимательный сотрудник из смежного отдела: работа механическая, обучение занимает пятнадцать минут, а независимость важнее опыта.
Пятнадцать тысяч рублей — это цена того, чтобы разговор с подрядчиком шёл о ваших числах. Без замера обсуждение точности превращается в обмен ожиданиями, а приёмка — в спор, где у обеих сторон нет общей линейки. Ровно та же логика лежит в основе методики измерения процесса до внедрения: сначала мерим, потом автоматизируем.
Облако или свой сервер: варианты 2026 года и 152-ФЗ
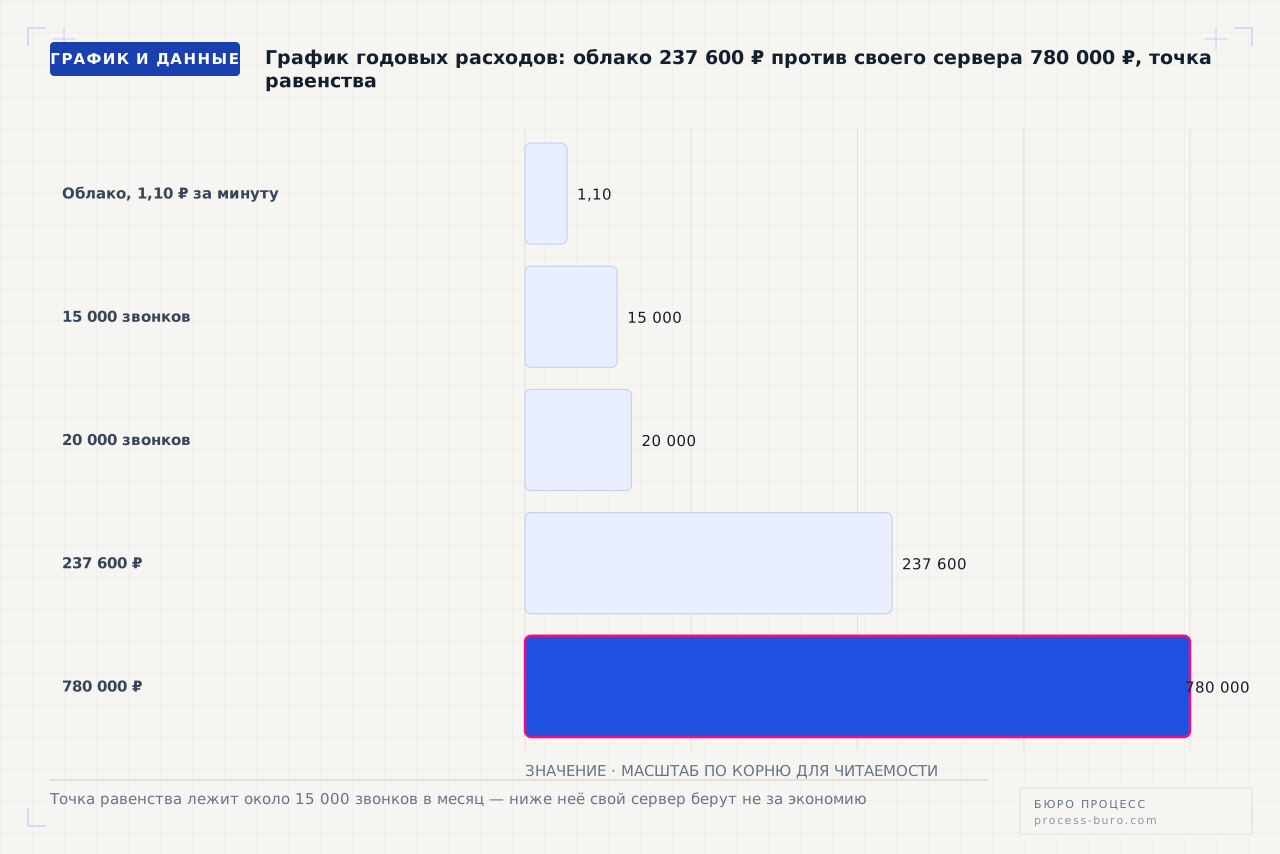
Развилка выглядит как техническая, а решается двумя вопросами: сколько у вас минут и что записано в вашем режиме обработки персональных данных. Российские облачные движки — Yandex SpeechKit и SaluteSpeech от Сбера — держат данные в России, что закрывает требование локализации, но остаются сторонней обработкой: с ними нужен договор-поручение. Свой сервер убирает передачу наружу целиком.
Из локальных вариантов на сентябрь 2026 года практический смысл имеют два. Whisper — открытые веса, скачиваются свободно и запускаются на своём железе; это не то же самое, что API OpenAI, оплата которого из России невозможна, и путать их не надо. Нужен GPU: на процессоре большая модель работает медленнее реального времени и на потоке в 18 000 минут не справляется. Vosk — российская открытая библиотека, работает на обычном сервере без GPU и хороша в узких сценариях с ограниченным словарём: ключевые слова, короткие команды, подтверждение записи. На дословной расшифровке длинных живых диалогов она заметно уступает и большой облачной модели, и Whisper.
| Параметр | Российское облако | Свой сервер |
|---|---|---|
| Разовые вложения | 0 ₽, ключ и интеграция | 180 000 ₽ на развёртывание и настройку |
| Переменная часть на 18 000 минут | 19 800 ₽/мес по 1,10 ₽ за минуту | 0 ₽, объём не влияет на счёт |
| Постоянная часть | нет | 35 000 ₽/мес аренда GPU-сервера в РФ плюс 15 000 ₽/мес сопровождение |
| Локализация данных по 152-ФЗ | Закрыта: серверы в России | Закрыта: данные не покидают контур |
| Договор-поручение на обработку | Нужен | Не нужен, если сервер ваш |
| Кто чинит качество | Вендор, вы влияете словарём и записью | Вы: подбор модели, дообучение, обновления |
Вывод из этой арифметики стоит проговорить прямо, потому что подрядчики его обычно опускают: на потоке меньше 15 000 звонков в месяц свой сервер распознавания дороже облака, и берут его не ради экономии, а ради режима данных. Если у вас медицинские разговоры, персональные данные особой категории или требование службы безопасности не выпускать записи наружу, переплата в 350–550 тысяч рублей в год — это цена закрытого контура, и её надо называть именно так, а не маскировать под «оптимизацию расходов». Что и как мы делаем для закрытого контура, описано на странице о безопасности и доступах.
Что делать с остатком ошибок
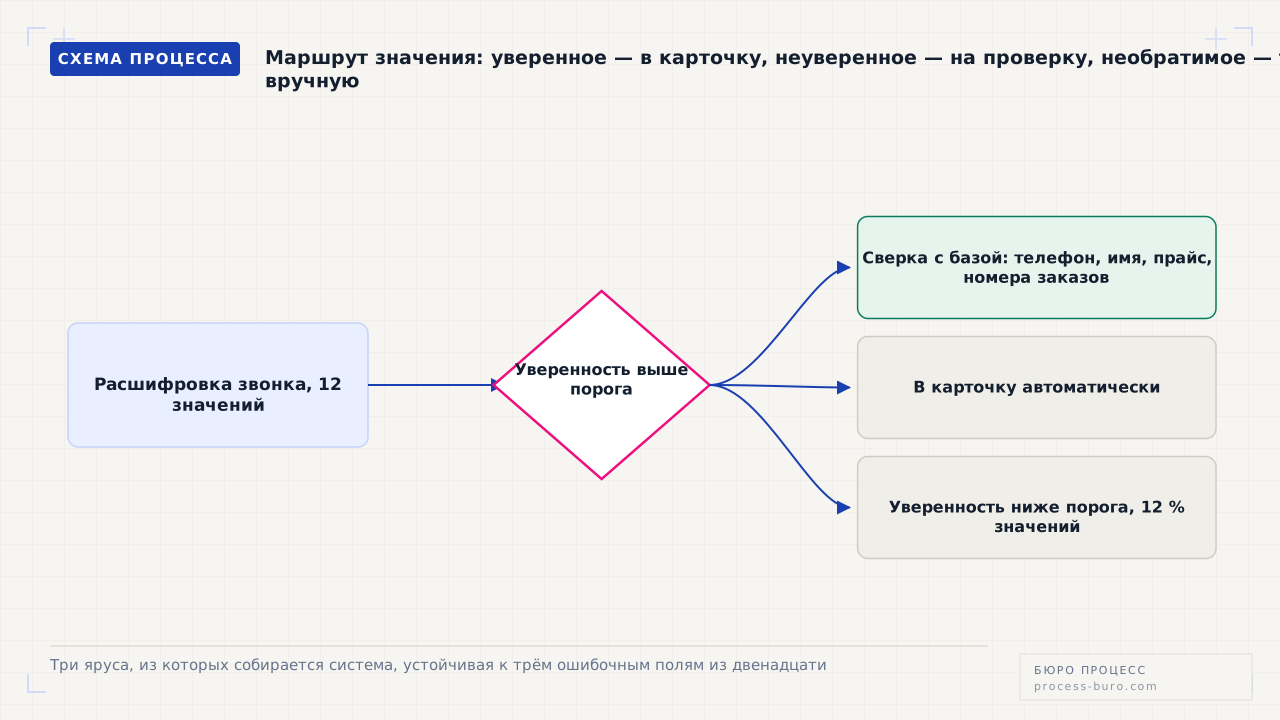
Три повреждённых поля из двенадцати никуда не денутся ни от смены вендора, ни от словаря — они уменьшатся, но останутся. Поэтому система проектируется не вокруг мечты о точной расшифровке, а вокруг того, что часть значений всегда будет неверной. Работающая конструкция состоит из трёх ярусов.
- 1Уверенность на уровне фрагмента. Движок возвращает не только текст, но и оценку уверенности по словам. Значения ниже порога помечаются и в карточке показываются иначе — например, подсвеченным полем с кнопкой прослушивания нужной секунды записи. Порог подбирается на той же выборке из 50 звонков: его двигают, пока доля пропущенных ошибок не станет приемлемой.
- 2Сверка с тем, что уже известно. Телефон, имя и компания подставляются из базы контактов по номеру звонящего, а не распознаются. Сумма проверяется по прайсу, номер заказа — по существующим номерам, дата — на попадание в разумный диапазон. Эта проверка убирает большую часть ошибок в числах бесплатно, потому что данные для сверки у вас уже есть.
- 3Запрет автодействий по неуверенным значениям. Правило простое и не обсуждается: ни одно необратимое действие — отгрузка, списание, запись клиента на конкретное время, отправка документа — не запускается со значения, помеченного как неуверенное. Такие случаи уходят в короткую очередь на подтверждение человеком. Тот же принцип разграничения обратимых и необратимых действий мы разбирали применительно к ИИ-агентам, и в голосе он работает точно так же.
Очередь проверки не должна быть большой, иначе она съедает всю экономию. Считается она так: проверяются не все двенадцать полей и не на всём потоке, а только поля, запускающие действие, и только на звонках, где действие вообще есть.
Разница между 8 и 96 часами — это разница между работающей системой и брошенной. Очередь, в которую валится всё подряд, перестаёт разбираться на второй неделе: люди сначала проверяют формально, потом жмут «подтвердить» не глядя, и через месяц вы имеете худший вариант из возможных — ошибки в базе и уверенность, что они проверены. Проектируйте очередь так, чтобы она физически помещалась в рабочий день, и режьте её порогом и сверкой, а не силой воли сотрудников.
Что можно улучшить бесплатно за один день
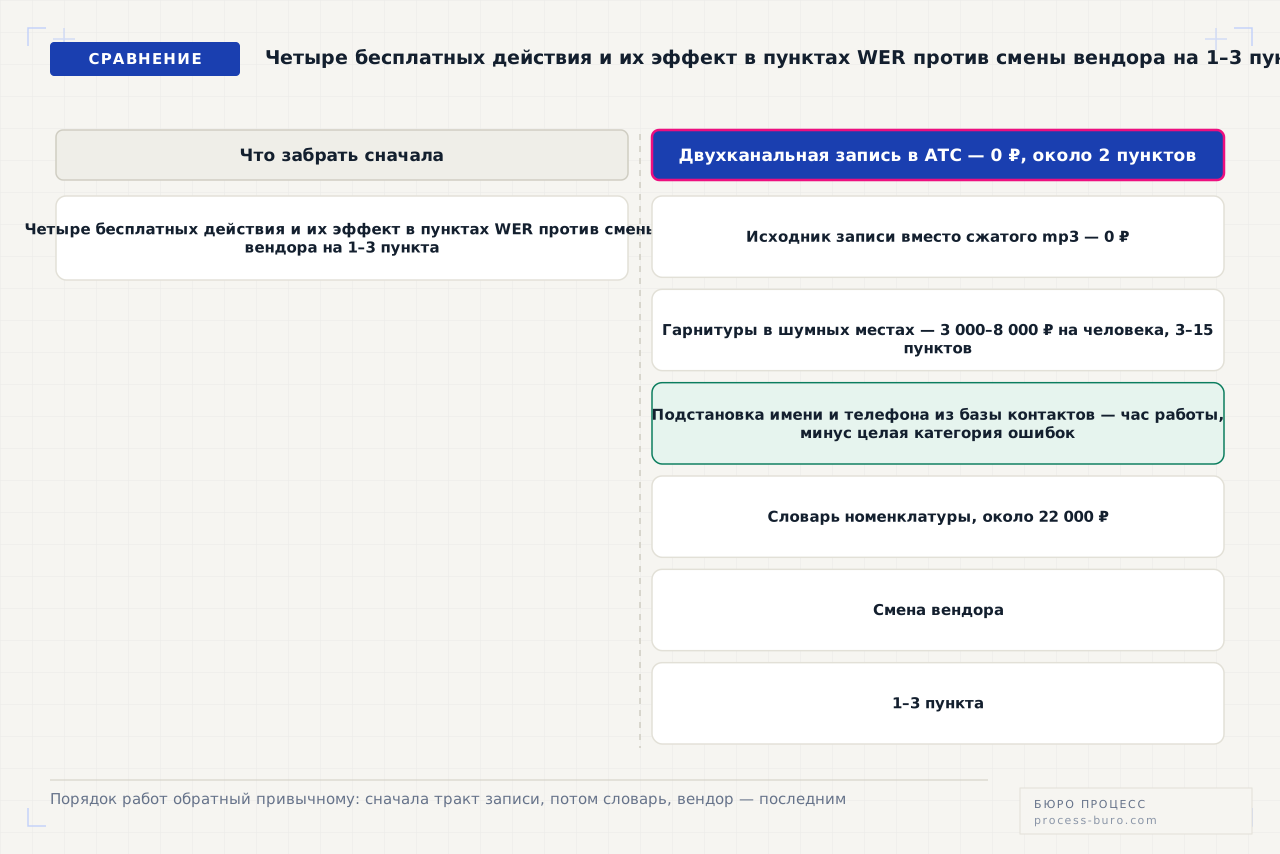
Прежде чем менять вендора или закладывать бюджет на свой сервер, стоит забрать то, что лежит на поверхности. Четыре действия ниже не требуют разработки и в сумме дают больше, чем разница между двумя приличными облачными движками.
- Включить двухканальную запись в АТС. Ноль рублей, полчаса работы, минус наложение речи и минус ошибки разделения говорящих — это те самые 2 пункта WER и почти все правила вида «сказал клиент, а не оператор».
- Забрать исходник записи, а не перекодированный файл. Если аналитика получает mp3 на 32 кбит/с, вы теряете качество дважды: сначала на канале, потом на сжатии. Выгрузка исходного формата обычно есть в API телефонии.
- Раздать гарнитуры с направленным микрофоном тем, кто сидит в шумном месте. 3 000–8 000 ₽ на человека, эффект — от 3 до 15 пунктов WER у этих конкретных сотрудников.
- Подставлять имя, телефон и компанию из базы контактов по номеру звонящего, а не распознавать их. Это убирает самую ошибкоёмкую категорию из шести целиком и стоит часа работы в интеграции.
Пятое действие — словарь своей номенклатуры и терминов. Оно уже требует работы и стоит около 22 000 ₽, но по соотношению цены и эффекта опережает любую смену движка: подробную процедуру сбора словаря и замера до и после мы разбираем в отдельном материале о том, как вдвое снизить ошибки на своих терминах.
Когда точность мерить и чинить не надо
Честный список случаев, в которых весь этот разговор лишний, — и в них мы сами отговариваем заказчика от расшифровки.
- 1Задача решается без распознавания вообще. Доля молчания, перебивания, темп речи, длина монолога оператора, факт и время звонка считаются по звуковой дорожке и по данным АТС, стоят копейки и работают на любом качестве записи. Если руководителю нужно понять, кто из менеджеров не даёт клиенту говорить, расшифровка для этого не нужна.
- 2Поток меньше 500 звонков в месяц. Полторы тысячи минут — это 20 часов прослушивания на ускоренном воспроизведении. Выборочная прослушка десяти звонков в неделю руководителем даёт ту же управленческую картину и не требует ни движка, ни словаря, ни очереди проверки.
- 3Процесс не описан. Если на один и тот же вопрос клиента пятеро сотрудников отвечают по-разному и правильного ответа не существует, точная расшифровка зафиксирует разнобой с точностью до слова, но ничего не изменит. Сначала описанный процесс, потом измерение — обратный порядок мы разбирали в материале про типичные ошибки внедрения.
- 4Нужны только теги и темы обращений. Как показано выше, для классификации хватает расшифровки среднего качества: 88–93 % точности по теме при 18 % ошибок по словам. Платить за улучшение WER в этой задаче — платить за то, что не влияет на результат.
- 5Никто не назначен разбирать находки. Точность имеет смысл только тогда, когда за расшифровкой следует чьё-то действие. Если у отчёта нет адресата с полномочиями, повышение точности с 82 % до 88 % ничего не изменит: не открывают одинаково и точный отчёт, и неточный.
Точность — не характеристика вендора, а характеристика вашего тракта: микрофона, канала, записи, словаря и того, что происходит с текстом после распознавания. Менять вендора имеет смысл последним, а не первым.